
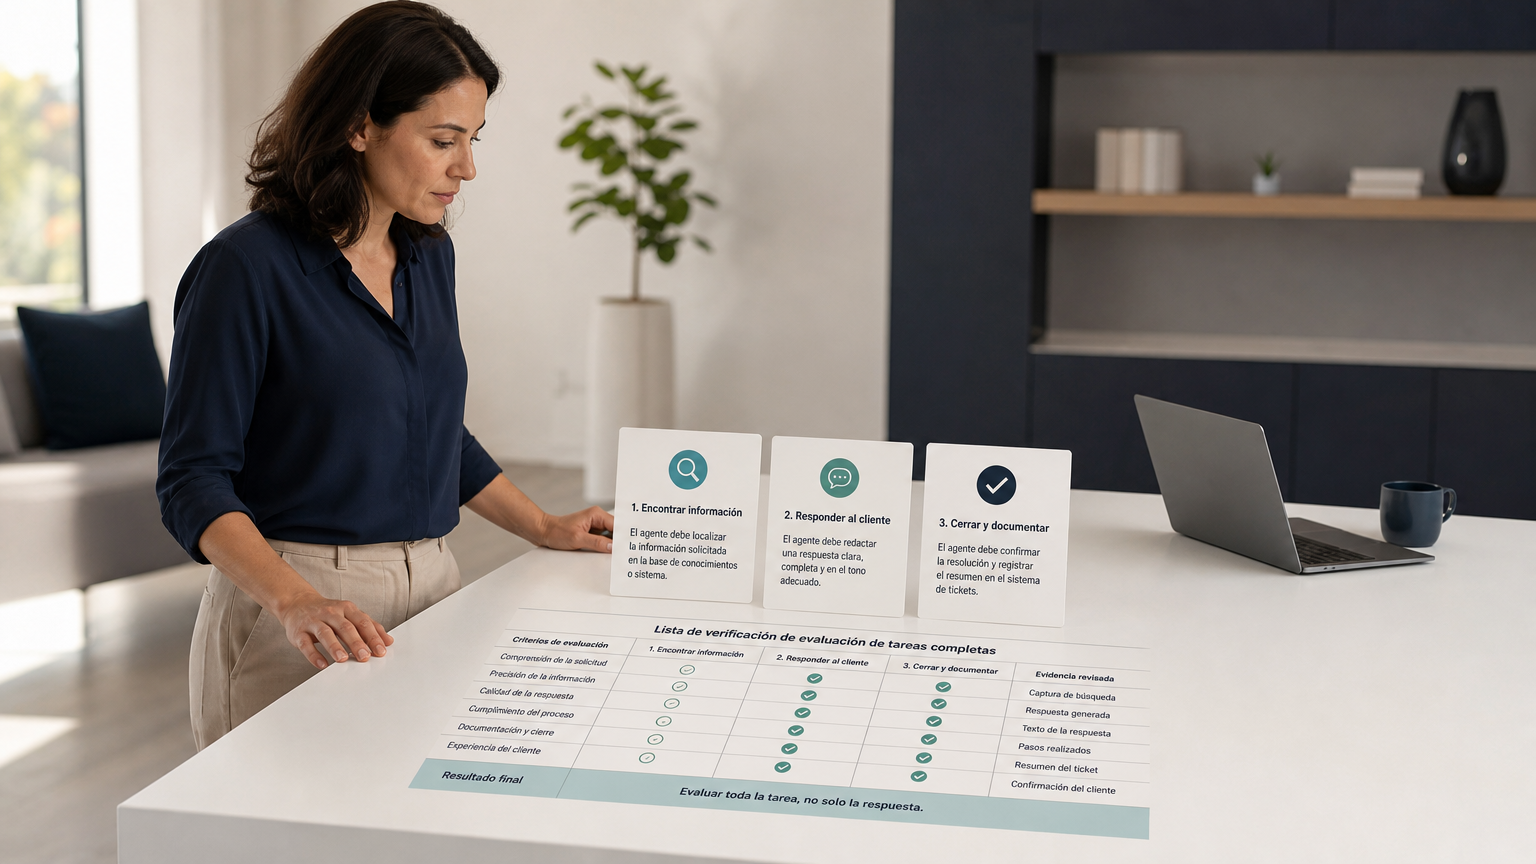
Los agentes de IA se suelen comparar por la calidad de sus respuestas. Sin embargo, una empresa no contrata una respuesta: necesita que una tarea termine bien, con los datos correctos, sin acciones indebidas y dejando un resultado que pueda comprobarse.
OpenAI ha presentado LifeVal, una evaluación centrada en tareas personalizadas de la vida real. Su interés para una pyme no está en copiar sus puntuaciones, sino en el cambio de enfoque: medir procesos completos en lugar de limitarse a preguntar si el texto generado parece convincente.
Qué mide LifeVal
El trabajo parte de encuestas sobre las tareas en las que las personas valorarían la ayuda de un asistente digital. La publicación oficial indica que se encuestó a 3.995 personas y que las actividades cubren ámbitos como cuidados, salud, educación, administración doméstica, finanzas, compras y acceso a servicios públicos.
Después, los autores construyeron tareas personalizadas con contexto, archivos y criterios de evaluación. El artículo técnico señala que los creadores de las tareas debían acreditar experiencia práctica y redactar una rúbrica; además, cada tarea pasó varias rondas de control humano.
La idea útil es sencilla: no basta con comprobar si un agente sabe conversar. Hay que observar si reúne la información adecuada, utiliza las herramientas correctas, respeta las restricciones, pide una decisión humana cuando corresponde y deja el proceso en el estado esperado.
Por qué importa a una pyme
Un chatbot público puede responder correctamente sobre un servicio y, aun así, registrar mal una cita. Un agente administrativo puede redactar un correo impecable y guardar un dato en la ficha equivocada. Una automatización puede completar todas sus llamadas técnicas sin producir el resultado de negocio previsto.
Por eso, la evaluación debería abarcar al menos cuatro capas:
- Resultado: qué debe quedar hecho al finalizar.
- Proceso: qué pasos y herramientas puede utilizar el agente.
- Límites: qué datos o acciones quedan fuera de su alcance.
- Comprobación: qué evidencia permite confirmar que el resultado es correcto.
Este enfoque encaja especialmente bien con flujos que combinan un chatbot, n8n, Supabase y servicios externos. La respuesta del modelo es solo una parte. También cuentan el registro creado, la ausencia de duplicados, los permisos aplicados, la trazabilidad y las confirmaciones humanas.
Una prueba pequeña que sí aporta información
Una pyme no necesita construir un gran benchmark. Puede empezar con una batería de diez a veinte tareas sintéticas que representen situaciones normales, ambiguas y problemáticas.
Por ejemplo, para un asistente de citas:
- Definir el resultado esperado de cada caso.
- Preparar datos ficticios y no personales.
- Indicar qué acciones puede ejecutar y cuáles requieren confirmación.
- Comprobar la respuesta visible y el estado final en agenda o base de datos.
- Registrar errores, omisiones, duplicados y accesos indebidos.
- Repetir las mismas pruebas después de cambiar el modelo, el prompt, una herramienta o un flujo.
La rúbrica debe ser concreta. “La respuesta es buena” no permite comparar versiones. “La cita se registra una sola vez, con servicio, fecha y contacto correctos, y no se confirma si falta un dato obligatorio” sí permite hacerlo.
Qué debería probar MMA Consulting
Para una arquitectura con n8n y Supabase, una primera prueba acotada podría utilizar doce conversaciones ficticias sobre una única tarea: solicitar, modificar o cancelar una cita.
La revisión debería comprobar:
- si el agente identifica la intención correcta;
- si solicita los datos realmente necesarios;
- si n8n ejecuta solo la rama prevista;
- si Supabase contiene un único registro coherente;
- si los permisos impiden consultar datos de otro usuario;
- si las acciones sensibles esperan confirmación;
- y si el sistema informa con claridad cuando no puede completar la tarea.
El valor de esta prueba no es obtener una nota llamativa, sino crear una referencia repetible. Esa referencia permite detectar regresiones cuando cambian el modelo, una integración, una política de acceso o el propio flujo de trabajo.
Lo que LifeVal no demuestra
LifeVal evalúa tareas de consumo personalizadas y no es un benchmark específico para pymes españolas. Una puntuación publicada no garantiza el mismo rendimiento en un negocio, con otros datos, herramientas, idiomas y restricciones.
También conviene separar la evaluación del modelo de la evaluación del sistema completo. Un buen modelo no corrige por sí solo permisos excesivos, datos incompletos, integraciones defectuosas o procesos mal definidos.
La conclusión práctica es que las pymes deberían dejar de probar agentes únicamente con preguntas sueltas. Antes de conectarlos a operaciones reales, conviene definir tareas completas, criterios de éxito verificables y límites claros. Ahí es donde una demostración empieza a convertirse en una implementación responsable.